OCR Tradisional vs VLM: Solusi Dokumen Bisnis Modern
Ringkasan
- Mengapa OCR tradisional berbasis template sering gagal menangani dokumen bisnis yang tidak terstruktur seperti invoice vendor yang beragam.
- Perbedaan fundamental antara ekstraksi teks mentah (OCR) dengan pemahaman kontekstual berbasis Vision-Language Model (VLM).
- Panduan strategis bagi perusahaan untuk beralih ke AI Document Processing guna mengurangi koreksi manual dan meningkatkan efisiensi operasional.
Saya masih sering menemukan tim operasional dan finance yang merasa kecewa dengan hasil implementasi OCR mereka. Keluhannya hampir selalu sama: “Kami sudah investasi di OCR, tapi kenapa tim saya tetap harus mengoreksi data secara manual setiap hari?”
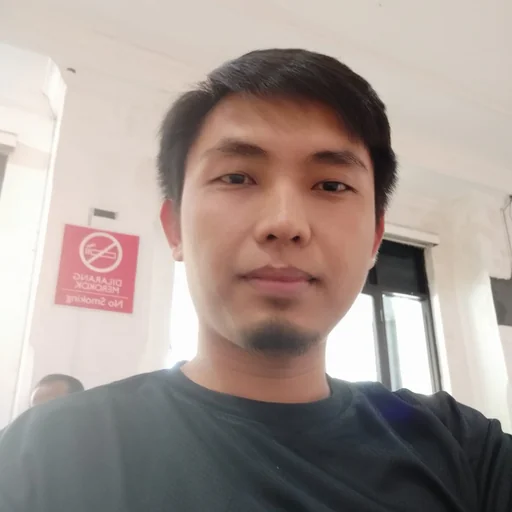
Biasanya, dokumen yang mereka proses adalah dokumen yang sangat dinamis: invoice dari puluhan vendor berbeda, nota hasil foto ponsel yang buram, surat jalan yang posisinya miring, atau formulir yang layout-nya berubah setiap bulan. Masalah utamanya bukan pada kemampuan sistem membaca huruf, melainkan pada ketidakmampuan sistem memahami konteks. OCR tradisional mungkin berhasil membaca teks "Rp 1.500.000", tetapi ia gagal memahami apakah angka tersebut adalah total tagihan, pajak PPN, atau saldo tersisa.
Kondisi ini semakin umum terjadi karena dokumen bisnis modern jarang sekali datang dalam format yang rapi dan konsisten. Di sinilah keterbatasan OCR berbasis template kaku mulai terasa, dan pendekatan baru berbasis Vision-Language Model (VLM) menjadi jauh lebih relevan untuk menjawab tantangan digitalisasi saat ini.
Keterbatasan OCR Tradisional di Dunia Nyata
OCR klasik (Optical Character Recognition), termasuk yang berbasis template atau rule-based, bekerja dengan prinsip koordinat. Sistem ini akan mencari teks pada area X dan Y untuk menentukan identitas data. Pendekatan ini bekerja dengan sangat baik jika dokumen memenuhi kriteria berikut:
- Memiliki layout yang tetap dan tidak pernah berubah.
- Hasil scan lurus, tajam, dan berkualitas tinggi.
- Menggunakan struktur yang sudah "dikenal" atau didaftarkan dalam sistem.
Namun, realitas bisnis sehari-hari jauh dari kondisi ideal tersebut. Berdasarkan pengalaman lapangan, ada beberapa kendala utama yang membuat OCR tradisional tumbang:
1. Variasi Kualitas Input
Banyak dokumen masuk dalam bentuk foto dari smartphone dengan sudut miring (skewed) dan pencahayaan yang tidak merata. OCR tradisional seringkali gagal melakukan deskewing atau koreksi perspektif dengan sempurna, sehingga teks terbaca terputus atau salah karakter.
2. Fragmentasi Layout Vendor
Bayangkan sebuah perusahaan yang bekerja dengan 50 supplier berbeda. Masing-masing supplier memiliki desain invoice sendiri. Ada yang meletakkan nomor invoice di pojok kanan atas, ada yang di tengah, dan ada yang menyatukannya dalam kalimat. Menggunakan OCR tradisional berarti Anda harus membuat 50 template berbeda. Jika satu vendor mengubah desain invoice-nya, sistem Anda akan rusak.
3. Gangguan Visual (Noise)
Dokumen bisnis seringkali mengandung stempel perusahaan, coretan tanda tangan, atau lipatan kertas. Bagi OCR tradisional, stempel yang menimpa teks sering dianggap sebagai karakter aneh atau justru menghapus teks di bawahnya, sehingga data menjadi tidak akurat.
4. Tabel yang Tidak Terstruktur
Tabel adalah musuh utama OCR berbasis rule. Ketika sebuah tabel memiliki jumlah baris yang dinamis atau kolom yang terputus ke halaman berikutnya, sistem tradisional seringkali gagal memetakan hubungan antara header kolom dengan nilai di bawahnya.
Dokumen Bisnis Modern Lebih “Berantakan” dari yang Dibayangkan
Dahulu, perusahaan memiliki kontrol penuh atas format dokumen masuk. Mereka mengirimkan formulir standar kepada mitra. Namun, di era digital saat ini, kontrol tersebut hilang. Vendor, cabang, bahkan karyawan yang mengirimkan laporan melalui WhatsApp menghasilkan variasi data yang sangat tinggi.
Menurut riset mengenai pemrosesan dokumen, ketergantungan pada OCR saja sudah tidak memadai karena kebutuhan bisnis modern kini berfokus pada data, bukan sekadar teks. Berikut adalah beberapa contoh nyata kompleksitas dokumen saat ini:
- Tim Finance: Menerima kuitansi dalam bentuk foto WhatsApp yang pencahayaannya minim.
- Bagian Logistik: Menerima surat jalan yang di-scan terburu-buru dengan kertas yang agak terlipat.
- HR Department: Menerima formulir pendaftaran yang diisi tangan lalu difoto, di mana tulisan tangan seringkali tidak konsisten.
Dalam kondisi seperti ini, biaya perawatan (maintenance) pendekatan berbasis template menjadi sangat mahal. Setiap kali ada format baru, tim IT harus membuat rule baru. Biaya operasional naik, namun akurasi tetap tidak stabil karena sistem tidak memiliki "kecerdasan" untuk beradaptasi.
Mengenal Vision-Language Model (VLM): Evolusi Pemrosesan Dokumen
Vision-Language Model (VLM) adalah lompatan teknologi yang menggabungkan kemampuan melihat (vision) dan memahami bahasa (language) dalam satu arsitektur neural network. Berbeda dengan OCR biasa yang hanya mengekstrak teks mentah, VLM mencoba memahami dokumen secara holistik—seperti cara manusia membaca.
Jika OCR tradisional bertanya, "Karakter apa yang ada di koordinat ini?", maka VLM bertanya, "Berdasarkan layout dan teks di sekitarnya, manakah bagian yang merupakan total tagihan?"
Kemampuan Utama VLM dalam Bisnis:
- Pemahaman Semantik: VLM mengerti konteks. Ia tahu bahwa kata "Total" yang diikuti angka di bagian bawah dokumen biasanya adalah nilai akhir yang harus dibayar, terlepas dari di mana posisi koordinatnya.
- Resiliensi terhadap Noise: VLM lebih tahan terhadap dokumen yang kurang sempurna, seperti foto miring, blur, atau dokumen dengan stempel yang menimpa teks.
- Zero-Shot Extraction: VLM dapat mengekstrak data dari dokumen yang belum pernah dilihat sebelumnya tanpa perlu pembuatan template khusus.
- Interaksi Natural: VLM memungkinkan pengguna untuk "bertanya" tentang isi dokumen. Contoh: "Apakah invoice ini sudah termasuk PPN?" dan sistem akan memberikan jawaban berdasarkan analisis visual dan tekstual.
Dengan kata lain, VLM tidak hanya "membaca", tetapi "mengerti" isi dokumen. Hal ini sangat krusial untuk dokumen semi-terstruktur atau tidak terstruktur yang menjadi standar dalam operasional bisnis modern.
Perbandingan Langsung: OCR Tradisional vs VLM
| Aspek | OCR Tradisional / Template-based | Vision-Language Model (VLM) | Pemenang untuk Dokumen Modern |
|---|---|---|---|
| Layout tetap & rapi | Sangat baik | Baik | Seri |
| Layout berantakan / berbeda-beda | Lemah | Kuat | VLM |
| Foto miring / kualitas rendah | Akurasi turun drastis | Lebih tahan | VLM |
| Memahami konteks teks | Hampir tidak ada | Ada | VLM |
| Perlu template baru | Hampir selalu | Sangat jarang | VLM |
| Maintenance jangka panjang | Tinggi | Lebih rendah | VLM |
| Cocok untuk invoice, nota, form bervariasi | Terbatas | Sangat cocok | VLM |
Kapan Perusahaan Anda Harus Beralih ke VLM?
Tidak semua perusahaan perlu mengganti sistem mereka. OCR tradisional masih cukup efisien jika dokumen Anda sangat standar, volume kecil, dan kualitas scan selalu terjaga dengan mesin scanner profesional.
Namun, Anda harus mulai mempertimbangkan pendekatan berbasis VLM jika mengalami gejala berikut:
- High Manual Effort: Tim Anda masih menghabiskan banyak waktu untuk melakukan koreksi manual setelah proses OCR selesai.
- Vendor Sprawl: Dokumen datang dari banyak sumber dengan format yang terus berubah-ubah.
- Mobile-First Input: Sebagian besar dokumen masuk dalam bentuk foto dari ponsel yang kualitasnya tidak konsisten.
- Template Fatigue: Tim IT merasa kewalahan karena harus terus-menerus membuat atau memperbarui template setiap kali ada perubahan layout dokumen.
- Need for Insight: Anda ingin mengekstrak data secara kontekstual, bukan sekadar memindahkan teks ke Excel.
Langkah Praktis Menuju Implementasi AI Document Processing
Beralih ke teknologi VLM tidak berarti Anda harus membuang seluruh infrastruktur lama. Banyak organisasi yang sukses melakukan transisi dengan strategi bertahap:
1. Audit Dokumen
Identifikasi jenis dokumen yang paling sering menyebabkan error. Apakah invoice? Surat jalan? Atau KTP/Paspor? Fokuskan implementasi VLM pada dokumen yang memiliki variasi layout tertinggi.
2. Proof of Concept (PoC) dengan Data Nyata
Jangan menguji AI dengan dokumen "ideal" yang bersih. Gunakan sampel dokumen nyata yang paling berantakan—foto miring, kertas lecek, atau dokumen dengan stempel besar. Di sinilah Anda akan melihat perbedaan nyata antara OCR tradisional dan VLM.
3. Membangun Pipeline Validasi
Gabungkan kemampuan ekstraksi VLM dengan validasi bisnis. Misalnya, jika VLM mengekstrak total tagihan, sistem harus memvalidasi apakah jumlah tersebut sesuai dengan penjumlahan item-item di dalam tabel invoice.
4. Integrasi Ekosistem
Integrasikan hasil ekstraksi langsung ke sistem existing seperti ERP atau database. Dengan AI yang lebih akurat, proses input data ke ERP menjadi otomatis dan mengurangi risiko human error.
Kesimpulan
OCR tradisional telah menjalankan perannya dengan baik di era dokumen terstruktur. Namun, dunia bisnis telah berubah. Dokumen kini lebih beragam, lebih berantakan, dan lebih sering datang dalam format digital yang tidak sempurna. Mengandalkan template kaku di tengah dinamika ini hanya akan menciptakan bottleneck operasional.
Vision-Language Model menawarkan paradigma baru: beralih dari sekadar "membaca teks" menjadi "memahami dokumen". Hasilnya adalah sistem yang lebih fleksibel, lebih tahan terhadap variasi, dan siap mendukung otomasi tingkat lanjut.
Jika tim Anda masih merasa frustrasi dengan hasil OCR yang tidak akurat atau biaya maintenance template yang membengkak, mungkin ini saatnya mengevaluasi pendekatan yang lebih modern. Kami di Pradha.id siap membantu perusahaan Anda menilai, merancang, dan membangun solusi AI Document Processing yang disesuaikan dengan karakteristik dokumen nyata di bisnis Anda.
Ingat: Dokumen bisnis tidak akan pernah sepenuhnya rapi. Teknologinya yang harus bisa menyesuaikan.
Solusi yang relevan
Jasa Pembuatan Website
Pembuatan website custom yang cepat, modern, dan siap jualan.
Related Articles
Arsitektur Pipeline AI Document Processing untuk Production
Bangun sistem AI Document Processing yang scalable dan tahan banting. Pelajari arsitektur pipeline dari upload file, Redis Queue, hingga ingestion database untuk beban produksi nyata.
AI Document Processing: Digitalisasi Rekam Medis & Form Kesehatan
Ubah tumpukan rekam medis kertas menjadi data digital terstruktur dengan AI Document Processing dan PWS Pradha. Tingkatkan akurasi data, percepat pelaporan, dan optimalkan layanan kesehatan Anda sekarang.
Otomasi Invoice & Kuitansi dengan AI Document Processing
Ubah proses input invoice manual yang memakan waktu berhari-hari menjadi hitungan jam. Pelajari bagaimana AI Document Processing mengeliminasi human error dan meningkatkan akurasi laporan keuangan.
Keamanan Data AI Document Processing: Lokal vs API Publik
Jangan pertaruhkan data rahasia perusahaan pada API publik. Pelajari mengapa implementasi AI Document Processing secara self-hosted di server lokal adalah solusi terbaik untuk menjaga privasi dan kepatuhan data.
Dapatkan Artikel Terbaru!
Berlangganan newsletter kami untuk mendapatkan tips dan insight menarik langsung ke inbox Anda.
Kami tidak akan pernah membagikan email Anda (No Spam).